Close
Отправить заявкуСвяжемся в течение 24 часов
Close
Отправить заявкуСвяжемся в течение 24 часов


Дубли — это страницы с одинаковым содержимым, т.е. они дублируют друг друга.
Причины, по которым страницы дублируются, могут быть разными:
Дубли страниц — это плохо для продвижения и раскрутки сайта, даже несмотря на то, что они могут появляться по естественным причинам. Дело в том, что поисковые роботы хуже ранжируют страницы, контент которых мало чем отличается от других страниц. И чем больше таких страниц, тем больше сигналов поисковым ботам, что это сайт не достоин быть в топе выдачи.
Что происходит с сайтом, у которого есть дубликаты страниц?
В общем, становится понятно, что дубли никому не нужны. Давайте разбираться, как найти и обезвредить дублирующиеся страницы на сайте.
Кирилл Бузаков,
SEO-оптимизатор компании SEO.RU:
«Когда мы получаем в работу сайт, мы проверяем его на наличие дублей страниц, отдающих код 200. Разберем, какие это могут быть дубли.
Дубли страниц с протоколами http и https.
Например: https://site.ru и http://site.ru
Дубли с www и без.
Например: https://site.ru и https://www.site.ru
Дубли со слешем на конце URL и без.
Например: https://site.ru/example/ и https://site.ru/example
Дубли с множественными слешами в середине либо в конце URL.
Например: https://site.ru/////////, https://site.ru/////////example/
Прописные и строчные буквы на различных уровнях вложенности в URL.
Например: https://site.ru/example/ и https://site.ru/EXAMPLE/
Дубли с добавлением на конце URL:
Например: https://site.ru/example/ и https://site.ru/example/index.html
Дубли с добавлением произвольных символов либо в качестве нового уровня вложенности (в конце или середине URL), либо в существующие уровни вложенности.
Например: https://site.ru/example/saf3qA/, https://site.ru/saf3qA/example/ и https://site.ru/examplesaf3qA/
Добавление произвольных цифр в конце URL в качестве нового уровня вложенности.
Например: https://site.ru/example/ и https://site.ru/example/32425/
Дубли с добавлением «звездочки» в конце URL.
Например: https://site.ru/example/ и https://site.ru/example/*
Дубли с заменой дефиса на нижнее подчеркивание или наоборот.
Например: https://site.ru/defis-ili-nizhnee-podchyorkivanie/ и https://site.ru/defis_ili_nizhnee_podchyorkivanie/
Дубли с некорректно указанными уровнями вложенности.
Например: https://site.ru/category/example/ и https://site.ru/example/category/
Дубли с отсутствующими уровнями вложенности.
Например: https://site.ru/category/example/ и https://site.ru/example/
Поиск дублей страниц можно произвести разными способами. Если вы хотите собрать все-все дубли и ничего не упустить, лучше использовать все нижеперечисленные сервисы совместно. Но для поиска основных достаточно какого-то одного инструмента, выбирайте, какой вам ближе и удобнее.
Парсинг сайта в специализированной программе
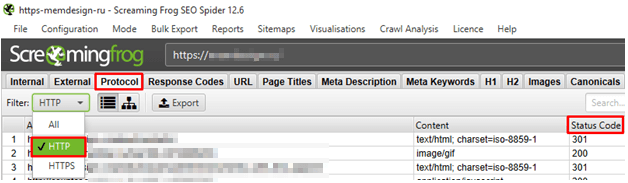
Для поиска дубликатов подходит программа Screaming Frog SEO Spider. Запускаем сканирование, а после него проверяем дубли в директории URL → Duplicate:
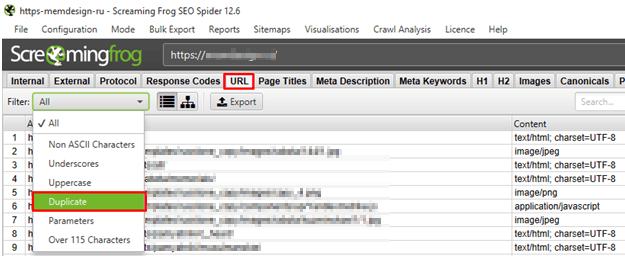
Кроме того, в директории Protocol → HTTP проверяем страницы с протоколом http — есть ли среди них те, у которых Status Code равен 200:
Онлайн-сервисы.
Первый, подходящий нашим целям сервис, — это ApollonGuru.
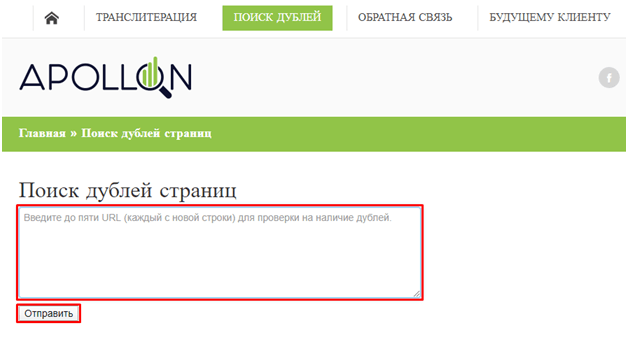
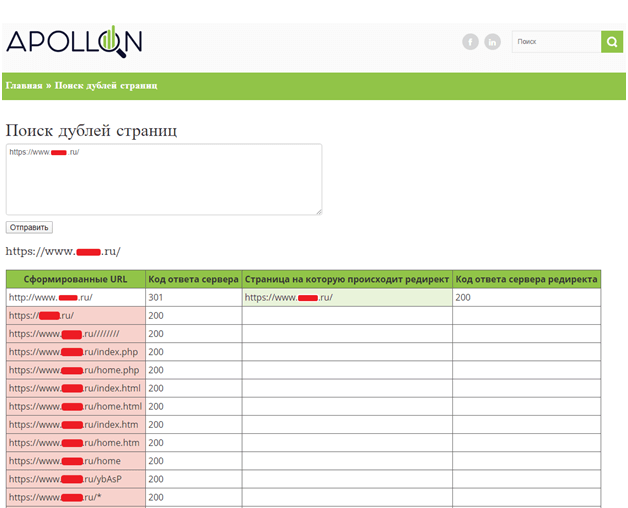
Кроме того, необходимо проверять, что с дублей настроены прямые 301 редиректы на основные версии этих же страниц.
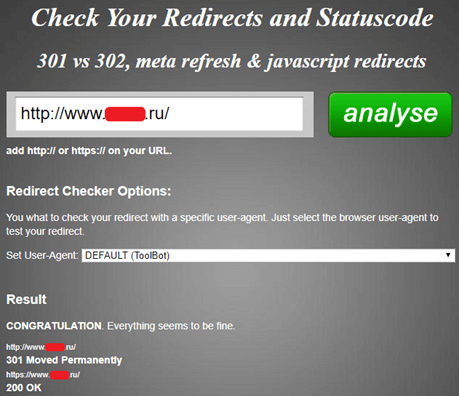
Также проверка дублей сайта возможна онлайн-сервисом Check Your Redirects and Statuscode, но он подходит только в том случае, если нужно проанализировать один URL-адрес:
Панели веб-мастеров Яндекса и Google.
Найти дублирующиеся страницы можно с помощью собственных инструментов поисковиков — Яндекс.Вебмастера и Google Search Console.
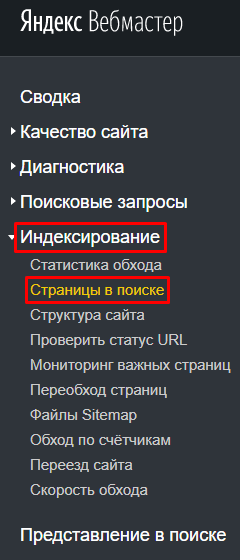
В Яндекс.Вебмастере анализируем раздел «Индексирование», далее — «Страницы в поиске»:
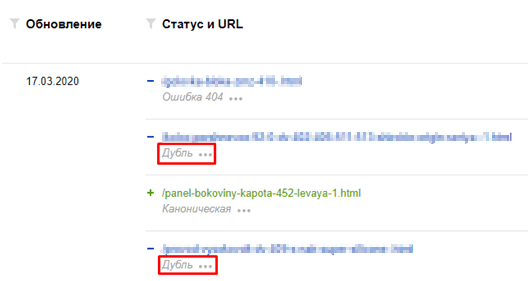
Там можно увидеть текущую индексацию сайта и искомые дубли страниц:
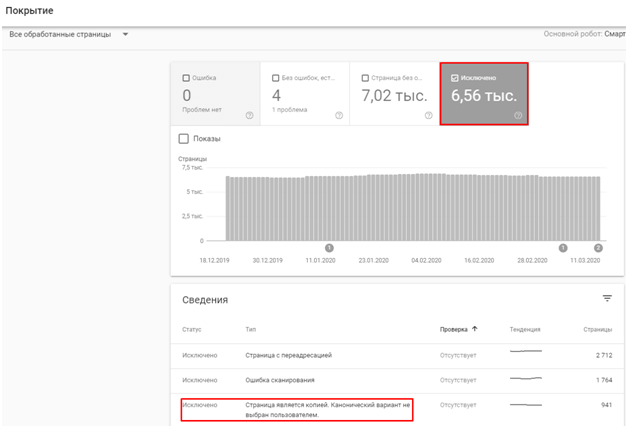
В Search Console анализируем раздел «Покрытие», а именно пункт с исключенными из индекса страницами:
Собираем все дубли в одну таблицу или документ. Затем отправляем их в работу программисту:
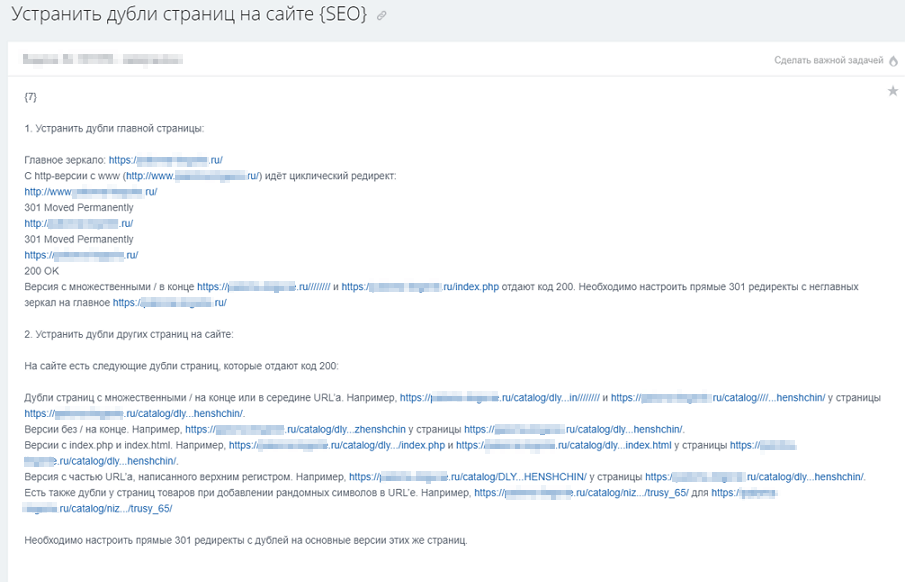
Старайтесь подробнее объяснить программисту задачу, так как адресов может быть много».
Евгений Костырев,
веб-программист компании SEO.RU:
«С дублирующимися страницами бороться можно разными способами. Если есть возможность, стоит использовать ручной метод. Но такая возможность есть не всегда, потому что здесь нужны серьезные навыки программирования: как минимум, нужно хорошо разбираться в особенностях CMS своего сайта.
Другие же методы не требуют специализированных знаний и тоже могут дать хороший результат. Давайте разберем их.
301 редирект — это самый надежный способ избавления от дублей, но при этом самый требовательный к профессиональным навыкам программиста.
Как это работает: если сайт использует сервер Apache, то нужные правила в файле .htaccess с помощью регулярных выражений.
Самый простой вариант 301 редиректа с одной страницы на другую:
Redirect 301 /test-1/ http://site.ru/test-2/
Устанавливаем 301 редирект со страницы с www на страницу без www (главное зеркало — домен без www):
RewriteCond %{HTTP_HOST} ^www\.(.*)$
RewriteRule^(.*)$ http://%1/$1 [L,R=301]
Организуем редирект с протокола http на https:
RewriteCond %{HTTPS} !=on
RewriteRule^(.*)$ https://%{HTTP_HOST}/$1 [R=301,L]
Прописываем 301 редирект для index.php, index.html или index.htm (например, в Joomla), массовая склейка:
RewriteCond %{THE_REQUEST} ^[A-Z]{3,9}\ /index\.(php|html|htm)\ HTTP/
RewriteRule^(.*)index\.(php|html|htm)$ http://site.ru/$1 [R=301,L]
Если же сайт использует Nginx, то правила прописываются в файле nginx.conf. Для перенаправления также нужно прописывать правила с помощью регулярных выражений, например:
location = /index.html {
return 301 https://site.com
}
Вместо index.html можно указать любой другой URL-адрес страницы вашего сайта, с которого нужно сделать редирект.
На этом этапе важно следить за корректностью новой части кода: если в ней будут ошибки, исчезнут не только дубли, но и вообще весь сайт из всего интернета.
Использование canonical указывает поисковому пауку на ту единственную страницу, которая является оригинальной и должна быть в поисковой выдаче.
Чтобы выделить такую страницу, нужно на всех URL дублей прописать код с адресом оригинальной страницы:
<link rel= “canonical” href= "http://www.site.ru/original-page.html”>
Можно прописывать их вручную, но это займет много времени, поэтому есть смысл использовать плагины. Например, в WordPress это YoastSEO или AllinOneSEOPack.
В 1С-Битрикс это делается с помощью языка программирования PHP в соответствующих файлах. Такая же история и с CMS Joomla: без вмешательства программиста или собственных навыков программирования здесь не обойтись.
В файле robots.txt содержатся инструкции для поисковых краулеров, как именно индексировать сайт.
Читать по теме: Как правильно заполнить файл robots.txt: критически важные моменты
Если на сайте есть дубли, можно запретить краулеру их индексировать с помощью директивы:
User-agent: *
Disallow: site.ru/contacts.php?work=225&s=1
Такой способ практически не требует навыков программиста, однако он не подходит, если дублей много: очень много времени уйдет на изменение robots.txt каждого дубля».
Выбирайте способ, исходя из собственных навыков программирования и личных предпочтений, и не давайте поисковикам повод сомневаться в релевантности и качестве вашего сайта.
Продвигаем сайты


